Language switching

Showing posts with label strom. Show all posts

Saturday, December 30, 2017

Vše nej v roce 2018!

Doufám, že jste všichni měli moc povedené Vánoce a užili si spoustu času s rodinou. Mně se povedlo vidět přes Vánoce všechny své žijící předky (i všechny ostatní žijící předky mých dětí) a taky se potkat se všemi svými sourozenci a všemi jejich dětmi. Velmi úspěšné Vánoce :)


V tomhle blogu bych chtěl zrekapitulovat cíle, které jsem si tady vytyčil na rok 2017, a jak moc se povedlo je splnit.

Rychlá rekapitulace cílů:
  1. Mít zdravého syna.
  2. Zdokonalit rodokmen.
    2
    .1. Identifikovat 40% předků do 10té generace, tj. 818 předků (z  2046ti).
    2.2. Nalézt polovinu předků mého dědy z otcovy strany v 7mé generaci - tj. 64.
  3. Napsat sérii blogů v češtině pro začátečníky s genetickou genealogií.
  4. Najít alespoň jednoho z mých dvou nejbližších neznámých předků.
    4.1. Tento cíl zahrnuje sběr maximálního možného počtu relevantních DNA vzorků.
    4.2. Pracovat na rekombinační mapě otcovských chromozomů.
  5. Otestovat naše děti.
  6. Začít sloupek "Předek týdne" - kde bloguju o jednom ze svých zesnulých předků.
  7. Pokračovat v práci s genetickýma shodama.


Rád bych začal těmi nejůspěšnějšími:

1. Mít zdravého syna.
Ano! Vítek je prostě super (už umí říkat "táta"), a navíc se mi díky energii z jeho narození podařilo prohloubit znalosti otcovské linie Krcháků.

2.2. Nalézt polovinu předků mého dědy z otcovy strany v 7mé generaci - tj. 64.
Díky velmi intenzivní práci s předtolerančními matrikami jsem dokázal tenhlé cíl splnit. Třikrát hurá!

7. Pokračovat v práci s genetickýma shodama.
Práce s genetickýma shodama mě bavila a myslím, že se i dařila. Podařilo se mi nalézt společného předka pro několik amerických příbuzných (tak, že jsem prostě postavil jejich český rodokmen).
I napsat článek o shodách na 23andMe se podařilo.


U většiny dalších témat se podařilo dosáhnout častečného úspěchu:

2.1. Identifikovat 40% předků do 10té generace, tj. 818 předků (z  2046ti).
Dnes jsem na čísle 635 předků. Někteří trochu nejistí. To znamená roční nárůst známých předku o 24%. To mi přijde senzační, a původní cíl prostě příliš agresivní a nerealistický.
Pokud bych chtěl znovu mířit na 24%, můj nový cíl pro 2018 bude 788 předků.

3. Napsat sérii blogů v češtině pro začátečníky s genetickou genealogií. 

4. Najít alespoň jednoho z mých dvou nejbližších neznámých předků. 
Na základě DNA testování mám teď kandidáta na otce mého prapradědečka Antonína Šuly, narozeného 1871. Je jím František Skrejšovský, 1837.
Další testování bude potřeba pro ověření této hypotézy.

Další neznámý předek bude těžší, díky kombinaci endogamie na Horňácku a malého množství Čechů s autozomálními testy.

5. Otestovat naše děti.
Další úspěch na poslední chvíli. Posílal sem testy svých dcer do 23andMe z více než hodinové fronty na poště v Seattlu až 23tího prosince. Byl jsem příjemně překvapen, že i ta mladší, tříletá, dokázal naplivat plnou zkumavku (snad, ověřené z laboratoře to zatím není).
Můj nejmladší je zatím bez testů, vyhlížím nový GSA chip od FTDNA...

Úplné selhání:

6. Začít sloupek "Předek týdne".

Bohužel, předek týdne je to jediné, co jsem v roce 2017 vůbec nestihl. Snad nám to všem vynahradím v 2018!


Tak jsme si to pěkně shrnuli a já už se těším, až se s vámi podělím o plány na rok 2018. A doufám, že vám se povedlo ty vaše plány splnit ještě lépe, než mě.

Tuesday, November 21, 2017

Cíle 2.2 roku 2017 - identifikace poloviny mých 7xpra dědy z otcovy strany

Pomalu se nám rok 2017 blíží ke konci, a já sotva napsal nějaký blog. Jak už jsem psal minule, bylo to hlavně kvůli narození našeho třetího dítka, a celkovému nedostatku času.

Jak jsem se i přesto vypořádal s vytyčenými cíli?
Se ctí můžu předvést alespoň jeden úspěch. Novou vlnu výzkumu předků mého dědy z tátovy strany - Emila Krcháka.

Na konci loňska jsem si tedy vytyčil cíl vypátrat alespoň polovinu mých 7xpra z dědovy strany.
A tady teď jsem (počet nalezených předků dědy Emila, generace na řádku):
Ač mi chybí už dva z mých 4xpra prarodičů, dokázal sem se dostat na vysněnou metu 64 7xpra. Další generace jsou bohužel zcela beznadějné...

Proč?
[- Na nějaké indexy pro takhle staré matriky rovnou zapomeňte. Zřejmé, ale velmi bolestivé.]
- Je náročné zkrotit s každou generaci dvojnasobný počet.
- Starší materiály jsou náročnější na práci. Žádné informace o rodičích, ani na svatebních záznamech, žádná čísla domů, žádná příjmení manželek...
- Neustálenost příjmení. Bohužel, příjmení nejsou ještě zcela fixována ani na přelomu 17ého a 18ého století.
- Některá příjmení jsou naopak velmi častá, a oplývá jimi klidně pětina vesnice.
- Čím hloubějí zkoumáme, tím širší množství far musíme pokrýt, a vypátrat v této době jakékoliv stěhování je obzvlášť oříšek...

Poznámka: všechen popisovaný výzkum probíhal na předtolerančních matrikách z Horňácka na actapublica, Velka nad Velickou [tehdy jen "Velká"].

Takže jak adresuju výšene uvedené problémy, abych si s nimi poradil?
  1. Neustále si udržuju seznam aktuálních příjmení, a snažím se je zapamatovat. Prakticky to vypadá tak, že na 90% procentech obrazovky mám otevřenou matriku, a na zbylých 10ti mám úzký sloupeček s příjmeními.
    Není prostě možné, procházet stejnou matriku znova a znova, a hledat při tom jen jedno, nebo pár příjmení. Projít matriku jednou (několikrát málokrát) zapisujíce rovnou všechny výskyty z celého seznamu příjmení je mnohem efektivnější.
    A kolik příjmení je rozumné? Já se snažím zkoumat na jednou všechna příjmení svých 7x pra. Na táhle úrovni se už většinou trošku opakují. Takže ja jich teď mám 38 - některá neznám, některá se opakují a u některých vím, že jsou z jiné fary.
  2. Udržuji si index všech svých předku napsaných tužkou na papíře.
    Kdykoliv potřebuju, můžu se podívat na vše co vím o svých předcích na této části stromu, se všemi jejich známymi daty a místu. Zcela nepostradatelná pomůcka.
  3. Zapisuju si každý detail.
    Jenom důkladným výzkumem všech nositelů mých příjmení z celé fary dokážu odlišit jeden z mnoha páru, kde se muž i žena jmenují úplně stejně (bohužel neměli ti naši předci na křestní jména příliš fantazie). Bez čísel domů a příjmení manželek potřebujeme pomoc nepřímých informací jako jsou jména kmotrů, vztah narození dětí se smrtí matky.
    Obdobně jako u stejně se jmenujících párů nám tato technika přináší schopnost propojit několik vdoveckých vdavek tak, abychom věděli, že jde o stejnou osobu.
  4. Trpělivost.
    Tohle všechno vyžaduje čas. Pokud nejste ochotni strávit 5 hodin a nezískat při tom jedinou informaci přímo o vašich předcích, tenhle postup asi není pro vás.
  5. Začínám se svatbama.
    Rozhodně nejlepší způsob je vybudovat si kvalitní základnu dospělých párů a pak je ověsit dětmi. A až úplně nakonec to doplnit o údaje o úmrtích.
    Prakticky to dělám nějak takhle: první svatby pro generaci T, pak děti z generace T+1, znova svatby, z generace T+1, děti T+2, a konečně úmrtí T+2...
  6. Ještě trochu víc trpělivosti.
  7. A potom partneři, kamarádi, babičky a strýčkové.
    Já v tomhle směru moc úspěšný nejsme, ale všechno o čem píšu krásně škáluje s počtem lidí. Takže jestli můžete, zapojte ostatní.
Hodně štěstí vašemu předtolerančnímu výzkumu. Pokud se do toho pustíte pořádně, určitě zjistíte, že nejedna informace vašich vzdálených příbuzných o vašich předcích je nepravdivá - chybní rodiče, potomci dítka, které zemřelo po 5ti dnech, ap. A to je pro mě pěkná odměna za dobře odvedenou práci.
Na druhou stranu, bez pořádného DNA výzkumu je ten papírový strom jenom jedna velká hodně nejistá hypotéza.

Friday, October 14, 2016

FamilyTreeDNA naležato

  Příjemná změna se stala u společnosti FamilyTreeDNA (https://www.familytreedna.com/) - která z firem věnujících se DNA testům, nám, genetickým genealogům, naslouchá asi nejvíc. FTDNA od tohoto týdne podporuje z leva do prava orientovaný formát rodokmenů. Ten se náramně hodí pro přehledné studium mnoha generací najednou, hodně do hloubky - přesně to, co genetický genealog potřebuje při hledání společných předků ve stromech svých genetických shod. Společní předci (jak jsme si ukazovali minule) se totiž často ve stromě schovávají pěkně hluboko.

  Pro názornou ukázku, normální do teď podporovaný rodokmen vám představu o mnoha předcích rozhodně nedal:

  Kdežto dnes krásně vidíme spoustu předků najednou!


Právě tak jak to potřebujeme pro hledání společných příjmení s našimi DNA shodami... dobrá práce, FamilyTree! MyHeritage, ač jsou rodokmeny její hlavní činnost, nebyla schopná tenhle pohled dodat za celou dobu existence (i přes to, že na Geni jsou).

Takže hodně štěstí při hledání společných předků v těchhle krásných přehledných stromech. Je dobře, že alespoň některé DNA testující společnosti svým zákazníkům naslouchají (na tebe se dívám, 23andMe).

Wednesday, October 12, 2016

23andMe se rozvádí s MyHeritage, umožní provázat jakýkoliv strom

  Včera byla na nových fórech 23andMe publikována zpráva o konci partnerství s MyHeritage. Stalo se to velmi pravděpodobně proto, že MyHeritage vstupuje na pole genetických shod a grafů populačních směsí (admixture). Zpráva na novém fóru 23andMe: http://www.23andmeforums.com/discussion/2864/family-tree-update

Ta zajímavější část je, že nám 23andMe umožní uložit do svého profilu cestu na jakoukoliv službu.
In the future, you will be able to post a link to any family tree from another website (including MyHeritage) to your DNA Relatives profile. I’ll let you know when this functionality has been added to DNA Relatives.
To by mělo zvýšit počet lidí, kteří na 23andMe uvádějí své stromy, a to je skvělé! Snad budou lidé často používat služeb, které jsou zadarmo a dostuplné pro všechny, jako WikiTree, FamilySearch nebo Geni. Problém s nejpoužívanější Ancestry je, že neumožňuje hostům vidět stromy platicích zákazníků - na rozdíl od MyHeritage.

Celkově se snad jedná o pozitivní změnu, která bude znamenat více profilů odkazujících na rodokmeny na 23andMe.

Monday, October 10, 2016

Začínáme

  Často jsem přemýšlel o tom, že si založím blog. Hlavně bych chtěl více vzdělat českou genealogickou komunitu v otázce genetické genealogie ale rád se budu také účastnit aktuálního anglického geneticko genealogického dění. Stává se mi, že mám myšlenku, kterou bych rád ke zrovna probíhající debatě prospěl, a blog je asi nejrozumější kanál.

  Jako své první téma jsem si vybral to, na čem by měla stát práce každého genetického genealoga. A to jeho rodokmen.

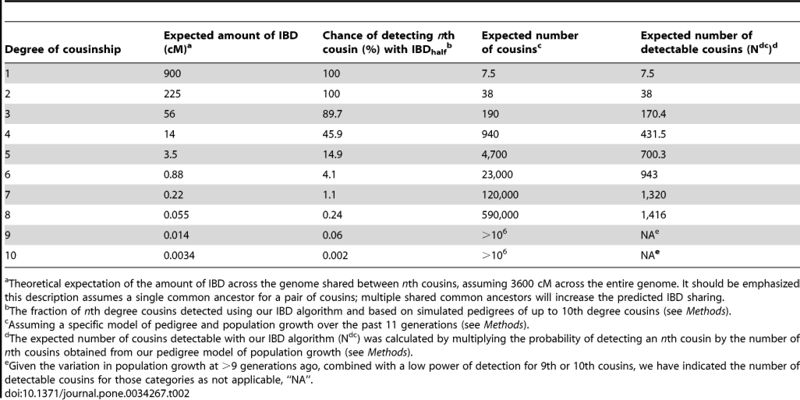
  Společnosti, u kterých si můžeme nechat otestovat svou DNA často zkreslují situaci - neustále mluví o 3rd cousins a 4th cousins - tj. o příbuzných, se kterými máme společného prapraděčka a praprababičku, respektive praprapradědečka a prapraprababičku. Protože mi české názvosloví přijde nedostatečné, bude tady na blogu používat 3tí bratranec / 4tý bratranec (ve smyslu obou pohlaví). Pokud se ovšem problematikou zabýváme hlouběji - navštivme například stránky Mezinárodní společnosti genetických genealogů: http://isogg.org/wiki/Cousin_statistics - zjistíme, že i s konzervativním odhadem počtu bratranců máme pravděpodobně více 8mých genetických bratranců než 7mých genetických bratranců než 6tých genetických bratranců, atd.


Co to znamená pro nás, genetické genealogy? Pokud chceme najít společné předky s našimi genetickými shodami, musíme seriózně zamakat na našich stromech! 8mí bratranci jsou na úrovni 7xpra, což znamená, že máme v této generaci 512 předků - a to dělá dokonce 1022 předků počítaje všechny generace od rodičů nahoru.

Vezměme si dva genetické genealogy, kteří spolu mají malou genetickou shodu. Pro rozumně spolehlivé nalezení společného předka musí mít oba ve svém stromě správně 1022 předků a porovnat je.
Takový cíl není v českých luzích a hajích nic jednoduchého. S tím jak vstupujeme do 17tého století u se u nás typicky záznamy začínají ztenčovat. I přesto bych se rád tomuhle cíli co nejvíce přiblížil a na tomhle blogu (mimo jiné) sledoval svůj postup.

Podívejme se na to první z perspektivy mých prarodičů. Nakonci to pak shrneme pro mě. Napsal jsem skript (malý počítačový prográmek), který zanalyzuje GEDCOM (počítačový způsob uložení rodokmenu) a vrátí požadované statistiky. Možná se v něm ještě nějaká muška najde, ale to že tu a tam nám eventuelně jeden člověk bude chybět, nebo přebývat nám zas tolik nevadí, pracujeme s většími čísly.

Má babička z maminčiny strany Anežka Kočíbová, *1935, gedmatch.com ID# M789839
gen#rel~DoBmatch#anc/gen#idd/gen%idd/gen#anc#idd%idd
1p190722100.00%22100.00%
2gp18731C44100.00%66100.00%
3Ggp18382C88100.00%1414100.00%
4GGgp18063C161593.75%302996.67%
53Ggp17784C323093.75%625995.16%
64Ggp05C644875.00%12610784.92%
75Ggp6C1281612.50%25412348.43%
86Ggp7C25641.56%51012724.90%
97Ggp8C51210.20%102212812.52%

Dědeček z maminčiny strany Jan Musil, *1927, gedmatch.com ID# M396921
gen#rel~DoBmatch#anc/gen#idd/gen%idd/gen#anc#idd%idd
1p189922100.00%22100.00%
2gp18601C44100.00%66100.00%
3Ggp18292C88100.00%1414100.00%
4GGgp17993C1616100.00%3030100.00%
53Ggp17674C3232100.00%6262100.00%
64Ggp5C643453.13%1269676.19%
75Ggp6C1283527.34%25413151.57%
86Ggp7C256238.98%51015430.20%
97Ggp8C512254.88%102217917.51%

Babička z tátovy strany Irena Moravcová, *1932, gedmatch.com ID# M425590
gen#rel~DoBmatch#anc/gen#idd/gen%idd/gen#anc#idd%idd
1p22100.00%22100.00%
2gp1C44100.00%66100.00%
3Ggp2C88100.00%1414100.00%
4GGgp3C161168.75%302583.33%
53Ggp4C321856.25%624369.35%
64Ggp5C642742.19%1267055.56%
75Ggp6C1281511.72%2548533.46%
86Ggp7C25672.73%5109218.04%
97Ggp8C51261.17%1022989.59%

Děda z tátovy strany Emil Krchák, *1930, žádná autozomální data
gen#rel~DoBmatch#anc/gen#idd/gen%idd/gen#anc#idd%idd
1p22100.00%22100.00%
2gp1C44100.00%66100.00%
3Ggp2C88100.00%1414100.00%
4GGgp3C161487.50%302893.33%
53Ggp4C322578.13%625385.48%
64Ggp5C642539.06%1267861.90%
75Ggp6C12832.34%2548131.89%
86Ggp7C25600.00%5108115.88%
97Ggp8C51200.00%1022817.93%

Je zřejmé, že mám před sebou ještě spoustu práce a jde i pěkně vidět, kam bych se měl zaměřit jako první - na rodinu svého dědy Krcháka.


Celkově mí vlastní předci, gedmatch.com ID# M240291 (PM240291M1, PM240291P1)
gen#rel~DoBmatch#anc/gen#idd/gen%idd/gen#anc#idd%idd
1p196022100.00%22100.00%
2gp19311C44100.00%66100.00%
3Ggp2C88100.00%1414100.00%
4GGgp3C1616100.00%3030100.00%
53Ggp4C3232100.00%6262100.00%
64Ggp5C645687.50%12611893.65%
75Ggp6C12810481.25%25422287.40%
86Ggp7C25613552.73%51035770.00%
97Ggp8C5125911.52%102241640.70%
Myslím si, že mít přes 50% známých 6xpra dědečků a prababiček je docela dobrý stav, ale určitě se dá pořádně vylepšit.


Budu se snažit publikovat mou cestu za pokrytím všech 7xpra nějakým smysluplným tempem - nejspíš parkrát za rok. Uvidíme jak mi to půjde a jak to pomůže s genetickou genealogií.

Těší mě, že jste dočetli až sem,
Kuba


P.S. Popsaná snaha, zmíněný skript pro práci s GEDCOM formátem a tenhle blog se inspirovaly tímto tématem řešeným na internetu v roce 2015. Rád bych z té doby zmíňil alespoň tento blog: http://thegeneticgenealogist.com/2015/08/11/how-much-of-your-family-tree-do-you-know-and-why-does-that-matter.